
JavaScript e SEO: che cosa vede Google di un catalogo in React
20 Settembre 2026 · Guide
Sì, Google legge anche i siti in JavaScript, ma lo fa in due passaggi e senza fare clic. Prima legge l’HTML, cioè il codice della pagina che riceve dal server. Poi, quando ha risorse disponibili, esegue gli script, le istruzioni JavaScript, e legge la pagina che producono. Per questo conviene che categorie e schede prodotto arrivino dal server con testi, dati tecnici e link già presenti. Filtri e configuratori possono invece funzionare nel browser, il programma con cui navighi.
Il problema non è JavaScript, ma ciò che appare soltanto dopo che viene eseguito uno script, che qualcuno fa una scelta o scorre la pagina. Google e i programmi che raccolgono le pagine per ChatGPT e Perplexity leggono subito ciò che il server invia nella prima risposta. La scelta tecnica va quindi fatta per ogni pagina, non una volta sola per tutto il sito.
Come Google legge un sito in JavaScript
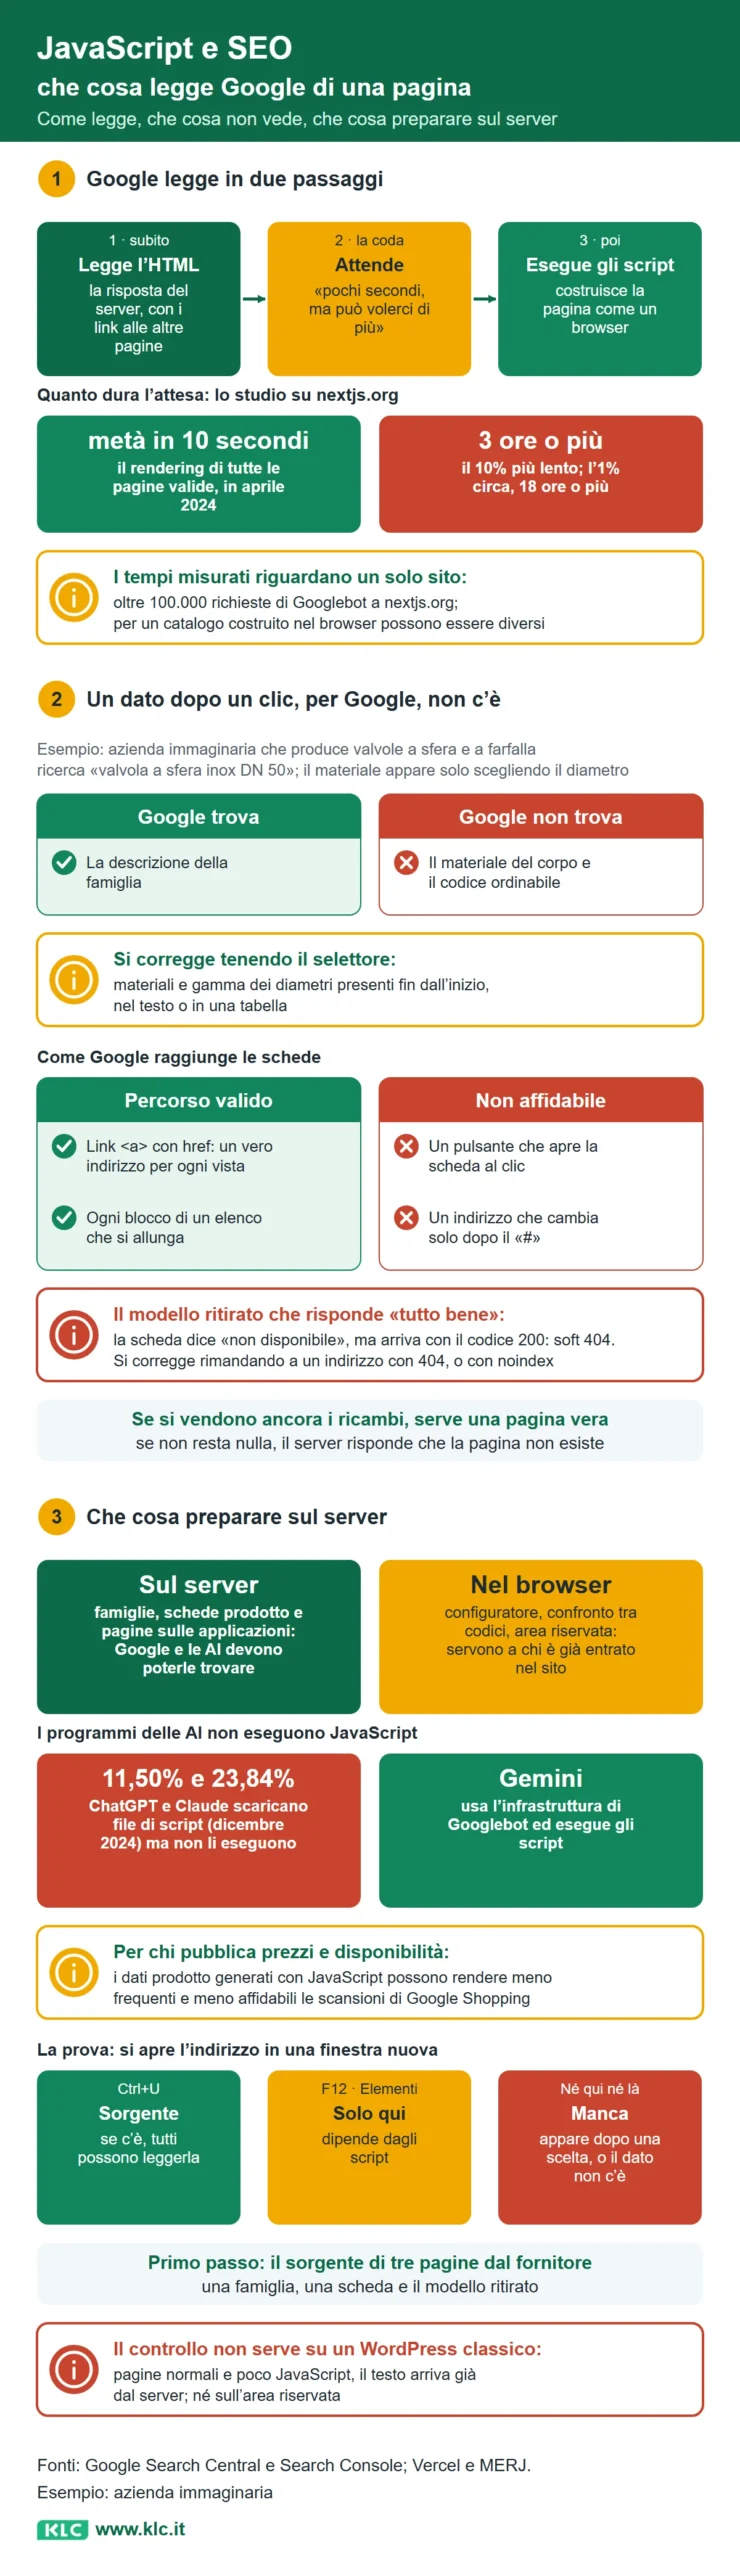
Googlebot, il programma che Google usa per visitare i siti, parte dalla risposta del server e raccoglie i link alle altre pagine. Poi mette la pagina in coda per il rendering: esegue gli script per costruire la pagina come farebbe un browser. Nella sua guida alla SEO per JavaScript, Google scrive che l’attesa è di «pochi secondi, ma può volerci di più».
Uno studio di Vercel e MERJ su oltre 100.000 richieste di Googlebot al sito nextjs.org, ad aprile 2024, ha misurato quanto può durare questa attesa. Google ha completato il rendering di tutte le pagine valide, per metà entro 10 secondi. Il 10% più lento ha però aspettato circa 3 ore o più, e l’1% circa 18 ore o più. Per gli indirizzi con parametri, come quelli dei filtri, l’attesa è stata più lunga. Il procedimento di Google è lo stesso per ogni sito, ma i tempi misurati riguardano solo il sito studiato. Per un catalogo costruito tutto nel browser possono essere diversi. Se una scheda cambia raramente, qualche ora conta poco. Conta di più il fatto che Google costruisce la pagina così com’è appena caricata, senza che nessuno la usi.
Scarica l’infografica (PNG ad alta risoluzione)
Incorpora l’infografica nel tuo sito
Puoi ripubblicare l’infografica usando questo codice, con il collegamento all’articolo originale.
Un dato che appare dopo un clic, per Google, non c’è
Google non fa clic, non scorre la pagina e non compila i campi: lo spiega quando dice che la Ricerca Google non interagisce con la pagina. Un’informazione che appare soltanto dopo un gesto del visitatore può quindi non entrare mai nella pagina valutata da Google.
Mettiamo il caso di un produttore di valvole a sfera e a farfalla per impianti di processo. È un’azienda immaginaria che vende a installatori e uffici tecnici dell’alimentare e della chimica. Il fornitore del sito propone di rifare il catalogo con React, uno strumento per costruire siti. Nella scheda della valvola a sfera, il materiale del corpo e il codice ordinabile appaiono solo quando il visitatore sceglie il diametro. Chi si occupa degli acquisti e cerca su Google «valvola a sfera inox DN 50» vuole proprio quelle informazioni. Google, però, costruisce la pagina senza selezionare nulla e trova solo la descrizione della famiglia. Il materiale non c’è, quindi la scheda non ha motivo di apparire per quella ricerca.
Si può correggere il problema mantenendo il selettore. Basta che i materiali disponibili e la gamma dei diametri siano presenti fin dall’inizio, nel testo o in una tabella. Il selettore continua a servire per trovare il codice ordinabile. Le varianti che le persone cercano davvero, come il corpo in inox, possono avere un indirizzo dedicato. Le altre combinazioni no, perché produrrebbero pagine quasi identiche.
Link e indirizzi veri per raggiungere le schede
Google segue solo i link scritti come elementi HTML con un indirizzo: nel codice sono i tag <a> con l’attributo href. Non è invece un percorso affidabile un pulsante che apre la scheda solo al clic, né un indirizzo che cambia soltanto nella parte dopo il simbolo «#». Anche quando il sito carica una sola pagina e poi ne sostituisce il contenuto, ogni vista deve avere un vero indirizzo, da poter aprire e copiare.
Nel catalogo delle valvole, la pagina della famiglia presenta i modelli in riquadri cliccabili realizzati come pulsanti. Per il visitatore non cambia nulla, ma Google può non avere un percorso per raggiungere quelle schede. Lo stesso problema riguarda gli elenchi che si allungano mentre scorri: ogni blocco di prodotti deve avere un proprio indirizzo. Nell’HTML va indicato anche l’indirizzo canonico, cioè quello della versione principale della pagina. Se JavaScript lo riscrive, Google chiede che rimanga identico all’originale.
Il prodotto ritirato che risponde «tutto bene»
Quando il sito costruisce le pagine nel browser, anche una pagina d’errore può arrivare con il codice 200, con cui il server segnala che la pagina è valida. Google chiama questi casi «soft 404». Per correggerli indica due possibilità: rimandare a un indirizzo per cui il server restituisce il codice 404, oppure inserire nella pagina d’errore il comando noindex, che la esclude dai risultati di ricerca.
Nel catalogo delle valvole succede tipicamente con un modello fuori produzione. La scheda dice «prodotto non disponibile», ma per Google rimane una pagina valida come tutte le altre. Per fare la prova si apre un indirizzo che di certo non esiste, per esempio un codice inventato, e lo si confronta con quello del modello ritirato. Lo stesso difetto si presenta quando una scheda rimane vuota perché l’archivio prodotti non risponde. Prima di scegliere quale codice restituire, bisogna decidere a che cosa serve la scheda. Se del modello si vendono ancora ricambi, serve una pagina vera che presenti i ricambi e il modello sostitutivo. Se invece non resta nulla, il server deve rispondere che la pagina non esiste.
Che cosa preparare sul server e che cosa lasciare al browser
Sapere che un sito «è fatto in React» non basta per capire se le pagine vengono costruite sul server o nel browser. Google consiglia di prepararle sul server oppure prima di pubblicarle: così il sito è più veloce e può leggerlo anche chi usa programmi che non eseguono JavaScript. Il rendering dinamico consiste nel fornire ai motori una versione già pronta e ai visitatori una versione in JavaScript. Per Google è una soluzione di ripiego, non di lungo periodo.
Con i sistemi di intelligenza artificiale (AI), questa distinzione conta ancora di più. Secondo uno studio di Vercel e MERJ sui crawler delle AI di dicembre 2024, i programmi con cui OpenAI, Anthropic e Perplexity raccolgono le pagine non eseguono JavaScript. Quelli di ChatGPT e Claude scaricano anche file di script, che rappresentano rispettivamente l’11,50% e il 23,84% delle loro richieste, ma non li eseguono. Per loro, quindi, una scheda che prende forma solo dopo gli script è vuota. Gemini, invece, usa l’infrastruttura di Googlebot ed esegue gli script. Per chi pubblica prezzi e disponibilità, i dati prodotto generati con JavaScript possono rendere meno frequenti e meno affidabili le scansioni di Google Shopping.
La scelta dipende quindi dal tipo di pagina. Famiglie, schede prodotto e pagine sulle applicazioni si preparano sul server, perché Google e le AI devono poterle trovare. Il configuratore, il confronto tra codici e l’area riservata possono invece funzionare nel browser: servono a chi è già entrato nel sito.
La prova prima del rilascio e le correzioni da fare per prime
Si parte da una scheda e da una caratteristica che deve essere presente, per esempio il materiale del corpo. Si apre direttamente l’indirizzo in una finestra nuova, senza passare dal menu: questo potrebbe aver già caricato i dati e nascondere il problema. Poi si cerca la caratteristica in due punti. Il primo è il codice sorgente, che in Chrome si apre con Ctrl+U e mostra l’HTML ricevuto dal server. Il secondo è la scheda Elementi degli strumenti per sviluppatori, accessibili con F12, dove si vede la pagina dopo l’esecuzione degli script. Se la caratteristica è nel sorgente, tutti possono leggerla. Se è solo negli Elementi, dipende dagli script. Se non si trova in nessuno dei due, appare soltanto dopo una scelta oppure il dato manca.
Al fornitore si consegnano l’indirizzo, la frase che manca, i passaggi seguiti e una schermata. Hanno la precedenza i difetti che impediscono di raggiungere o leggere le pagine da cui arrivano richieste; un avviso del browser senza effetti visibili può aspettare. Dopo la correzione si prova anche una scheda dello stesso modello che prima funzionava, perché una modifica condivisa da più pagine può causare altri problemi. Il Controllo URL di Search Console conferma che Google può leggere la pagina. Un esito positivo, però, non garantisce la presenza nei risultati: più avanti si ricontrolla se Google l’ha inserita nel proprio indice.
Quando questo controllo non serve
Con un sito WordPress classico, che usa pagine normali e poco JavaScript, il problema non si presenta: il testo arriva già dal server. Non occorre fare il controllo nemmeno sulle pagine che non devono essere trovate, come l’area riservata con i listini dei clienti.
Come cambia il catalogo delle valvole
Il sito del produttore di valvole ora funziona in due modi. Le pagine delle famiglie e le schede arrivano dal server complete di materiali, diametri e link veri tra categoria e modello. Nel browser rimane il selettore del diametro, che permette di arrivare al codice ordinabile. Il modello fuori produzione ha una pagina vera se i ricambi sono ancora in vendita; se non ci sono più ricambi, il server risponde che la pagina non esiste. Chi cerca una valvola a sfera in inox di un determinato diametro può trovare una scheda con quelle informazioni. I programmi di ChatGPT e Perplexity leggono la stessa scheda letta da Google. Prima del rilascio, il primo passo è chiedere al fornitore il codice sorgente di tre pagine: una famiglia, una scheda e il modello ritirato.
Domande frequenti
Devo rinunciare a React o a Vue per farmi trovare su Google?
No. Questi stessi strumenti possono preparare le pagine sul server o generarle prima della pubblicazione. A contare è il modo in cui viene costruita ciascuna pagina: il controllo del codice sorgente permette di capirlo in pochi minuti.
Fonti e riferimenti
- Google Search Central, Understand the JavaScript SEO basics. Le fasi di scansione, rendering e indicizzazione, la coda di rendering, i soft 404 nei siti costruiti nel browser, il canonical da tenere uguale all’HTML e il rendering sul server come scelta consigliata.
- Google Search Central, Make your links crawlable. Google segue i link scritti come elemento <a> con attributo href.
- Google Search Central, Fix lazy-loaded content. La Ricerca Google non clicca e non scorre; ogni blocco di uno scorrimento infinito deve avere un indirizzo proprio.
- Google Search Central, Dynamic rendering as a workaround. Il rendering dinamico come soluzione di ripiego, non di lungo periodo.
- Google Search Central, Merchant listing (Product, Offer) structured data. I dati prodotto generati con JavaScript rendono meno frequenti e meno affidabili le scansioni di prezzo e disponibilità.
- Guida di Search Console, URL Inspection tool. Che cosa mostra la prova dal vivo e perché un esito positivo non garantisce la presenza nei risultati.
- Vercel e MERJ, How Google handles JavaScript throughout the indexing process, luglio 2024. Tempi fra scansione e rendering su oltre 100.000 richieste di Googlebot al sito nextjs.org, aprile 2024.
- Vercel e MERJ, The rise of the AI crawler, dicembre 2024. I crawler delle AI di OpenAI, Anthropic e Perplexity non eseguono JavaScript; Gemini usa l’infrastruttura di Googlebot.
Approfondisci il servizio: SEO tecnica.