
Checklist di audit SEO tecnico: controlli, prove e priorità
19 Ottobre 2026 · SEO
Un audit SEO tecnico deve spiegare quali problemi impediscono ai motori di scoprire, interpretare, indicizzare e servire le pagine importanti. Un elenco automatico di “errori” non basta: molti avvisi sono innocui, mentre problemi seri possono non comparire in un singolo crawler.
Questa checklist organizza l’audit per domande, fonti di prova e impatto. L’obiettivo finale è un backlog ordinato, con test di accettazione chiari.
Prima di trasformare un avviso in un intervento, lo schema aiuta a leggere il danno e le pagine coinvolte.
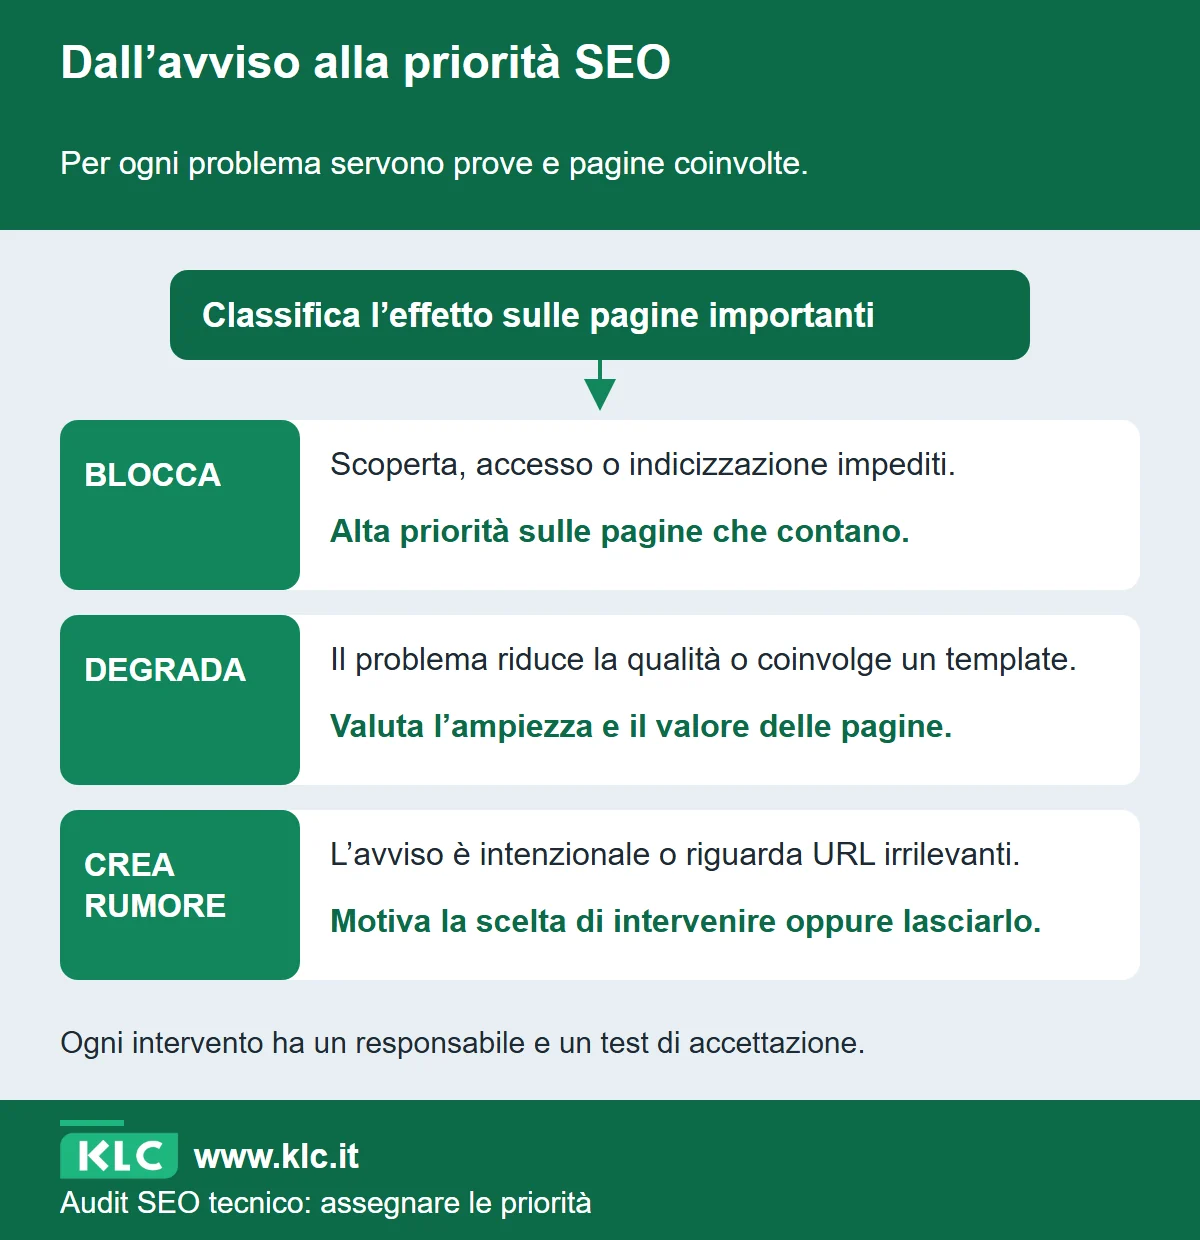
Scarica l’infografica (PNG ad alta risoluzione)
Incorpora l’infografica nel tuo sito
Puoi ripubblicare l’infografica usando questo codice, con il collegamento all’articolo originale.
1. Definire il perimetro prima di scansionare
Registrare:
- domini, sottodomini, protocolli e ambienti;
- CMS, framework e modalità di rendering;
- lingue e paesi;
- tipi di pagina e template;
- aree protette, filtri, ricerca interna e parametri;
- migrazioni o release recenti;
- strumenti disponibili: Search Console, log, analytics, monitoraggio uptime;
- pagine prioritarie per traffico, ricavi, lead o funzione.
Senza perimetro non è possibile distinguere un’anomalia locale da un problema sistemico.
2. Scoperta e crawlabilità
Verificare come vengono trovate le URL importanti.
Per un distributore italiano di ricambi, il crawler è lo strumento che percorre i collegamenti del sito. Può trovare tutte le categorie nel menu e ignorare una scheda raggiungibile soltanto digitando un codice nella ricerca interna. Nell’audit quella scheda va cercata confrontando il catalogo dei prodotti con le pagine effettivamente raggiunte dallo strumento, prima di dichiarare completo il controllo.
Controlli
- link interni HTML raggiungibili;
- sitemap XML coerenti con le URL canoniche;
- robots.txt e direttive applicate;
- status code delle risorse e delle pagine;
- profondità e pagine orfane;
- parametri, calendari, filtri e combinazioni potenzialmente infinite;
- collegamenti generati solo via JavaScript;
- host duplicati o ambienti di staging accessibili.
Prove
Usare più fonti: crawl del sito, sitemap, esportazione CMS, Search Console e, per siti grandi o critici, log server. Il crawler mostra ciò che riesce a raggiungere; non mostra necessariamente ciò che Googlebot sta richiedendo.
3. Indicizzazione e canonicalizzazione
Per campioni rappresentativi, controllare:
- meta robots e header
X-Robots-Tag; - canonical autoreferenziali e canonical verso altre URL;
- coerenza tra canonical, sitemap e link interni;
- duplicati causati da parametri, maiuscole, slash, protocolli o host;
- pagine con contenuto quasi identico;
- URL escluse ma ancora collegate;
- pagine indicizzate che non dovrebbero ricevere traffico;
- differenza tra canonical dichiarata e scelta dal motore.
Il canonical è un segnale di consolidamento, non un comando per nascondere qualsiasi problema. Se una pagina non deve esistere o essere accessibile, va scelta la soluzione corretta: redirect, rimozione, autenticazione, noindex o revisione dell’architettura.
Un’officina può presentare la stessa lavorazione a indirizzi diversi, aperti da filtri del catalogo. Il canonical indica quale pagina viene proposta a Google come riferimento. Nell’audit conta controllare che rimandi proprio alla lavorazione descritta, senza accorpare per errore una pagina dedicata all’alluminio con una dedicata all’acciaio. Le due pagine rispondono a esigenze di acquisto diverse.
4. Redirect e status code
Costruire una matrice per:
- 200 corretti;
- 3xx intenzionali;
- catene e loop;
- 404 e 410;
- soft 404;
- errori 5xx e timeout;
- redirect verso destinazioni non equivalenti;
- pagine importanti che cambiano URL senza mappatura.
Priorità alta per errori che coinvolgono pagine con link, traffico, conversioni o ruolo nella navigazione. Un 404 su una URL mai collegata non ha lo stesso impatto di una categoria eliminata con centinaia di link.
5. Rendering e contenuto visibile
Confrontare HTML iniziale, DOM renderizzato e contenuto osservato dai tool di ispezione. Verificare:
- title, meta robots e canonical disponibili in modo stabile;
- contenuto principale presente;
- link interni utilizzabili;
- dati strutturati generati correttamente;
- lazy loading di immagini e contenuti;
- dipendenze da API o script che falliscono;
- differenze tra desktop e mobile;
- errori console e risorse bloccate.
Il fatto che un browser mostri la pagina non garantisce che tutti gli elementi critici siano disponibili in modo affidabile al crawler.
6. Architettura, template e linking interno
Valutare per tipo di pagina:
- H1 e struttura dei titoli;
- contenuto unico rispetto al template;
- breadcrumb;
- link a categorie, prodotti e pagine correlate;
- paginazione;
- filtri e faccette;
- moduli o componenti che duplicano grandi blocchi;
- anchor text descrittive;
- priorità delle pagine nella navigazione.
Campionare più URL per template. Un controllo su una sola pagina può non rilevare errori condizionali legati a dati mancanti o varianti.
7. Prestazioni e stabilità dell’esperienza
Analizzare dati reali e test di laboratorio distinguendo:
- tempi server;
- peso e ordine delle risorse;
- immagini e font;
- JavaScript di terze parti;
- cache e CDN;
- layout instabile;
- interazioni lente;
- differenze tra template, dispositivi e paesi.
Non trasformare ogni raccomandazione di performance in un ticket SEO. Collegare l’intervento a pagine, utenti e impatti osservati. Le ottimizzazioni devono preservare funzionalità, misurazione e accessibilità.
8. Sitemap, hreflang e internazionalizzazione
Se il sito è multilingue o multiregionale, verificare:
- URL canoniche e indicizzabili nelle sitemap;
- codici lingua e paese validi;
- reciprocità delle annotazioni hreflang;
- riferimento a se stessa;
- destinazioni equivalenti;
x-default, se pertinente;- redirect automatici che impediscono l’accesso;
- coerenza tra lingua della pagina e segnali tecnici.
Gli errori vanno letti per cluster, non corretti URL per URL quando la causa è nel template.
9. Dati strutturati
Controllare soltanto i tipi pertinenti al contenuto reale. Verificare:
- proprietà obbligatorie e consigliate;
- valori visibili anche nella pagina;
- coerenza tra markup e contenuto;
- identificatori stabili;
- errori introdotti da più plugin;
- pagine non idonee che ricevono markup;
- monitoraggio dopo il rilascio.
Il markup non sostituisce contenuto, accessibilità o qualità. Non va aggiunto per promettere elementi che la pagina non contiene.
10. Sicurezza e affidabilità tecnica
Includere controlli che possono influire su disponibilità e fiducia:
- HTTPS coerente e risorse miste;
- certificati e rinnovi;
- malware o pagine iniettate;
- plugin e componenti obsoleti;
- errori server ricorrenti;
- uptime e risposte lente;
- ambienti di test indicizzati;
- backup e possibilità di rollback per le modifiche SEO.
L’audit SEO non sostituisce un audit di sicurezza, ma deve segnalare rischi che possono compromettere scansione e reputazione.
11. Come assegnare le priorità
Per ogni problema registrare:
| Campo | Domanda |
|---|---|
| Evidenza | Come sappiamo che il problema esiste? |
| Ampiezza | Quante URL o template coinvolge? |
| Valore | Quali pagine o obiettivi tocca? |
| Gravità | Blocca, degrada o crea solo rumore? |
| Confidenza | La causa è dimostrata o ipotizzata? |
| Costo | Quanto è complesso correggere e testare? |
| Dipendenze | Chi o che cosa deve intervenire prima? |
| Test di accettazione | Come sapremo che è risolto? |
Una formula numerica può aiutare, ma non deve nascondere dipendenze e rischio. Un problema moderato nel template di tutte le pagine può avere priorità superiore a un errore grave su una URL irrilevante.
Un costruttore di macchine può avere una pagina per le linee di confezionamento esclusa da Google e piccoli avvisi su vecchie notizie aziendali. Il primo intervento riguarda la pagina che aiuta a scegliere la linea. La prova della correzione deve mostrare che il blocco è stato rimosso e che Google può elaborare la pagina; la comparsa nei risultati va poi monitorata.
12. QA dopo la correzione
Ogni ticket deve contenere:
- esempio iniziale;
- comportamento atteso;
- ambiente di test;
- campione di URL;
- controllo automatico e manuale;
- verifica di effetti collaterali;
- data di rilascio;
- monitoraggio post-release;
- procedura di rollback.
Dopo la pubblicazione, ricontrollare log, Search Console, crawl e indicatori del template. La chiusura del ticket tecnico non coincide sempre con la completa rielaborazione da parte del motore.
Checklist sintetica
- Perimetro e URL prioritarie definiti.
- Scoperta, robots e sitemap verificati.
- Indicizzazione e canonical controllati su campioni.
- Redirect, errori e soft 404 classificati.
- Rendering confrontato tra HTML e DOM.
- Template e linking interno analizzati.
- Performance valutata con dati reali e test.
- Hreflang e internazionalizzazione verificati.
- Dati strutturati pertinenti e coerenti.
- Sicurezza, uptime e ambienti controllati.
- Problemi prioritizzati per impatto e confidenza.
- Ogni correzione ha un test di accettazione.
Domande frequenti
Un crawler può fare da solo l’audit?
No. È una fonte importante, ma va integrata con dati del CMS, Search Console, analytics, log, ispezioni e contesto di business.
Tutti gli errori devono essere corretti?
No. Alcuni sono intenzionali, irrilevanti o troppo costosi rispetto all’impatto. L’audit deve spiegare quali interventi cambiano realmente il sistema.
Serve sempre analizzare i log?
Non sempre. È particolarmente utile per siti grandi, problemi di crawl, migrazioni, variazioni difficili da spiegare o differenze tra ciò che il crawler trova e ciò che i bot richiedono.
Quando l’audit è concluso?
Quando esistono prove, priorità, owner e test di accettazione. La scansione iniziale è solo l’inizio del lavoro.
Un audit tecnico ben eseguito concentra il lavoro sulle pagine che aiutano a ottenere richieste commerciali. Il titolare riceve priorità comprensibili e prove delle correzioni, mentre il budget viene destinato ai problemi che ostacolano la ricerca e la consultazione dei prodotti.
Approfondisci il servizio: Audit SEO.