
Crawl waste nei cataloghi: come controllare faccette, parametri e URL senza valore
2 Settembre 2026 · Guide
Il crawl waste è la parte della scansione che un motore spende su indirizzi senza contenuti utili da scoprire o aggiornare. In un catalogo industriale può nascere da filtri che producono molte versioni della stessa selezione. Prima di chiedere interventi al fornitore del sito, individua quali indirizzi devono restare accessibili ai clienti e quali devono comparire nei risultati di ricerca.
In breve
- Il crawl waste riguarda scansioni spese su indirizzi senza contenuti utili.
- Il crawl mostra i link del sito; i log mostrano le richieste effettive dei bot.
- Le correzioni vanno provate su una categoria, proteggendo i percorsi utili ai clienti.
Prima di iniziare
Il perimetro di «Crawl waste nei cataloghi» deve essere approvato prima di raccogliere dati. Le prime due condizioni da rendere esplicite sono «Pattern URL inventariati» e «Googlebot verificato nei log». Senza queste fondamenta il team rischia di produrre un’analisi corretta dal punto di vista tecnico ma incapace di modificare il processo reale.
Prima di confrontare crawl e log, occorre allineare il campione: intervallo temporale, fuso orario, host inclusi, regole di normalizzazione dei parametri e modalità con cui viene riconosciuto Googlebot. Va anche annotato quali filtri sono generati dal frontend, quali dalle sitemap o dai link interni e quali sopravvivono da configurazioni precedenti.
Criteri di completamento
| Condizione | Evidenza richiesta | Governance |
|---|---|---|
| Pattern URL inventariati | Documento, configurazione, test o dato che dimostra il completamento | Owner e data di revisione |
| Googlebot verificato nei log | Documento, configurazione, test o dato che dimostra il completamento | Owner e data di revisione |
| Faccette utili selezionate | Documento, configurazione, test o dato che dimostra il completamento | Owner e data di revisione |
| Robots, noindex e canonical usati correttamente | Documento, configurazione, test o dato che dimostra il completamento | Owner e data di revisione |
| Sitemap pulite | Documento, configurazione, test o dato che dimostra il completamento | Owner e data di revisione |
| Test pilota prima del rollout | Documento, configurazione, test o dato che dimostra il completamento | Owner e data di revisione |
Un pattern può essere segnato come risolto quando un nuovo crawl non lo genera più nei percorsi indesiderati, i log confermano il comportamento atteso e i controlli su canonical, robots, noindex e sitemap non introducono conflitti. Il test va ripetuto sia su URL già noti sia su combinazioni appena create.
Quando il metodo non è sufficiente
Su cataloghi distribuiti tra CDN, motore di ricerca interno, PIM e frontend, una correzione SEO può incidere su cache, navigazione o disponibilità dei prodotti. Le modifiche che toccano regole server, dati personali nei parametri o grandi insiemi di URL richiedono quindi verifiche infrastrutturali, di sicurezza o legali pertinenti al caso.
L’esito va descritto in termini osservabili: pattern rimossi dai link, richieste dei crawler redistribuite e URL utili ancora raggiungibili. Da questi segnali si può formulare una valutazione tecnica, non dedurre automaticamente crescita organica o ricavi, perché domanda, concorrenza, qualità del catalogo e comportamento dei motori restano variabili esterne.
Distinguere crawl waste e crawl budget
Il crawl budget diventa critico soprattutto nei siti grandi o molto dinamici. Il crawl waste è una diagnosi più concreta: richieste ripetute a URL senza valore, parametri, redirect, errori o faccette inutili.
Inventariare le fonti di moltiplicazione
Ordinamento, prezzo, disponibilità, sessione, tracking, paginazione, ricerca interna, combinazioni di attributi e varianti possono creare URL. Ogni pattern deve avere funzione e regola.
Usare log e crawl insieme
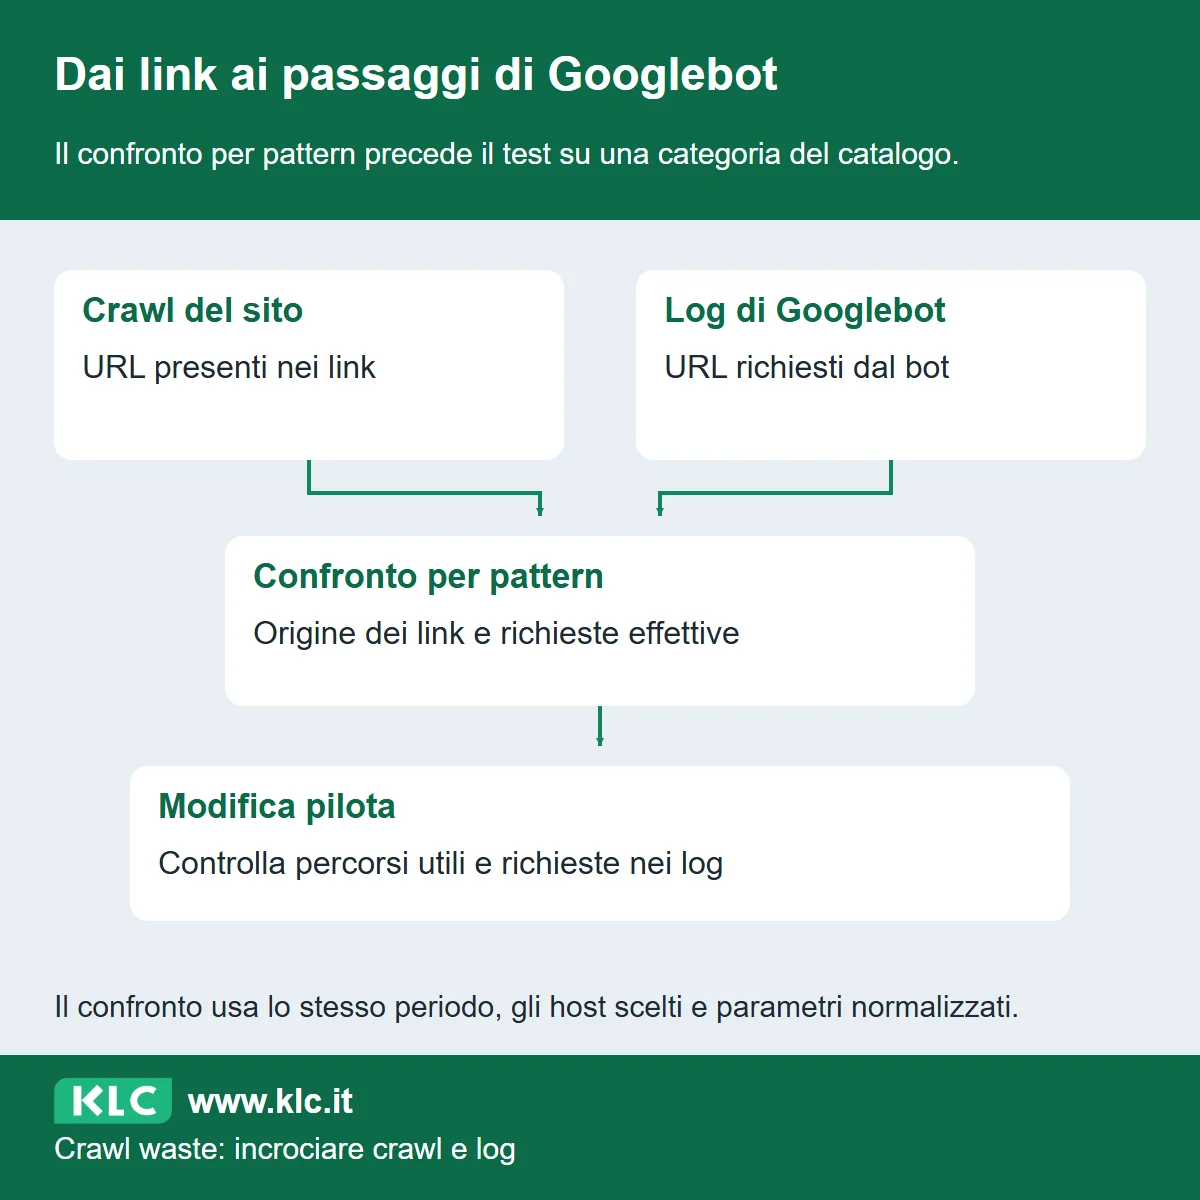
Il crawler mostra ciò che il sito collega; i log mostrano ciò che i bot richiedono. L’incrocio identifica spazi invisibili, richieste legacy e differenze tra Googlebot e altri crawler.
Crawl e log descrivono aspetti diversi dello stesso catalogo. Incrociarli per pattern aiuta a scegliere dove provare la correzione.
Scegliere lo strumento corretto
Robots limita la scansione ma non garantisce rimozione dall’indice; noindex richiede accesso; canonical consolida segnali ma non impedisce sempre il crawl; rimuovere link e parametri inutili agisce alla fonte.
Proteggere le faccette utili
Alcune combinazioni hanno domanda e contenuto autonomo. Devono avere URL stabile, Title, testo, linking e controllo delle combinazioni. Le altre restano funzioni di navigazione.
Monitorare dopo le modifiche
Riduzione delle richieste inutili, aumento della quota su template importanti, status più puliti e maggiore rapidità di aggiornamento sono segnali, non garanzie di ranking.
Matrice operativa
| Pattern | Valore utente | Indicizzazione | Intervento |
|---|---|---|---|
| Ordinamento | Temporaneo | No | URL non linkato/canonical |
| Filtro singolo richiesto | Alto | Possibile | Landing governata |
| Combinazione rara | Basso | No | Faccetta non indicizzabile |
| Ricerca interna | Alto per utente | Generalmente no | Bloccare spazio e misurare |
| Parametro tracking | Nessun contenuto nuovo | No | Pulizia link/canonical |
Applicazione operativa
Il primo deliverable è un catalogo dei pattern URL, non un elenco di singole pagine. Ogni pattern indica origine, parametri, link che lo generano, status, canonical, indicizzazione desiderata e valore utente. Questo rende possibile intervenire sul template.
Nei log si segmentano Googlebot, altri bot e utenti, verificando gli indirizzi secondo la documentazione Google. Si confronta la quota di richieste su categorie, prodotti, filtri, redirect, errori e asset. Il dato assoluto conta meno della distribuzione.
Le modifiche vanno testate su una faccetta o categoria pilota. Cambiare robots, canonical e linking su tutto il catalogo contemporaneamente può rendere difficile capire quale intervento ha prodotto l’effetto.
Come misurare il risultato
Si osservano richieste su URL non desiderati, catene, errori, tempo di risposta, scoperta di nuovi prodotti e frequenza di scansione degli URL prioritari. La riduzione delle richieste inutili è positiva se non riduce l’accesso a contenuti utili.
L’indicizzazione va controllata separatamente: bloccare la scansione di un URL già indicizzato non equivale a rimuoverlo.
Esempio ragionato
Un catalogo permette di combinare colore, materiale, disponibilità, ordine e fascia prezzo. Ogni click crea un URL linkabile. I log mostrano che gran parte delle richieste dei crawler riguarda ordinamenti e combinazioni senza domanda.
Il progetto conserva landing governate per materiale e applicazione, rende gli ordinamenti non linkabili, pulisce i parametri e aggiorna sitemap e canonical. Dopo il test, la scansione si concentra maggiormente su prodotti e categorie.
Checklist di esecuzione
- Pattern URL inventariati
- Googlebot verificato nei log
- Faccette utili selezionate
- Robots, noindex e canonical usati correttamente
- Sitemap pulite
- Test pilota prima del rollout
Errori da evitare
- Bloccare tutto in robots senza verificare l’indice.
- Applicare noindex a milioni di URL e aspettare risparmio immediato.
- Creare landing per ogni filtro disponibile.
- Analizzare solo il crawl del tool e non i log.
- Confondere minore crawl con migliore ranking automatico.
Dal filtro del cliente alla pagina da trovare su Google
Un distributore di valvole permette di scegliere il materiale del corpo e il tipo di attacco. L’ordinamento per codice cambia soltanto la sequenza dei prodotti. La selezione delle valvole per vapore, invece, può aiutare chi cerca un componente adatto a quell’impiego. Per decidere quali pagine pubblicare, chiedi al responsabile di prodotto quali differenze vanno spiegate prima di un acquisto.
Una pagina per un’applicazione deve offrire qualcosa che la categoria generale non chiarisce. Può spiegare i limiti d’impiego e rimandare ai prodotti compatibili attraverso la navigazione del catalogo. Il semplice cambio di titolo sopra gli stessi articoli non basta a motivare un nuovo indirizzo.
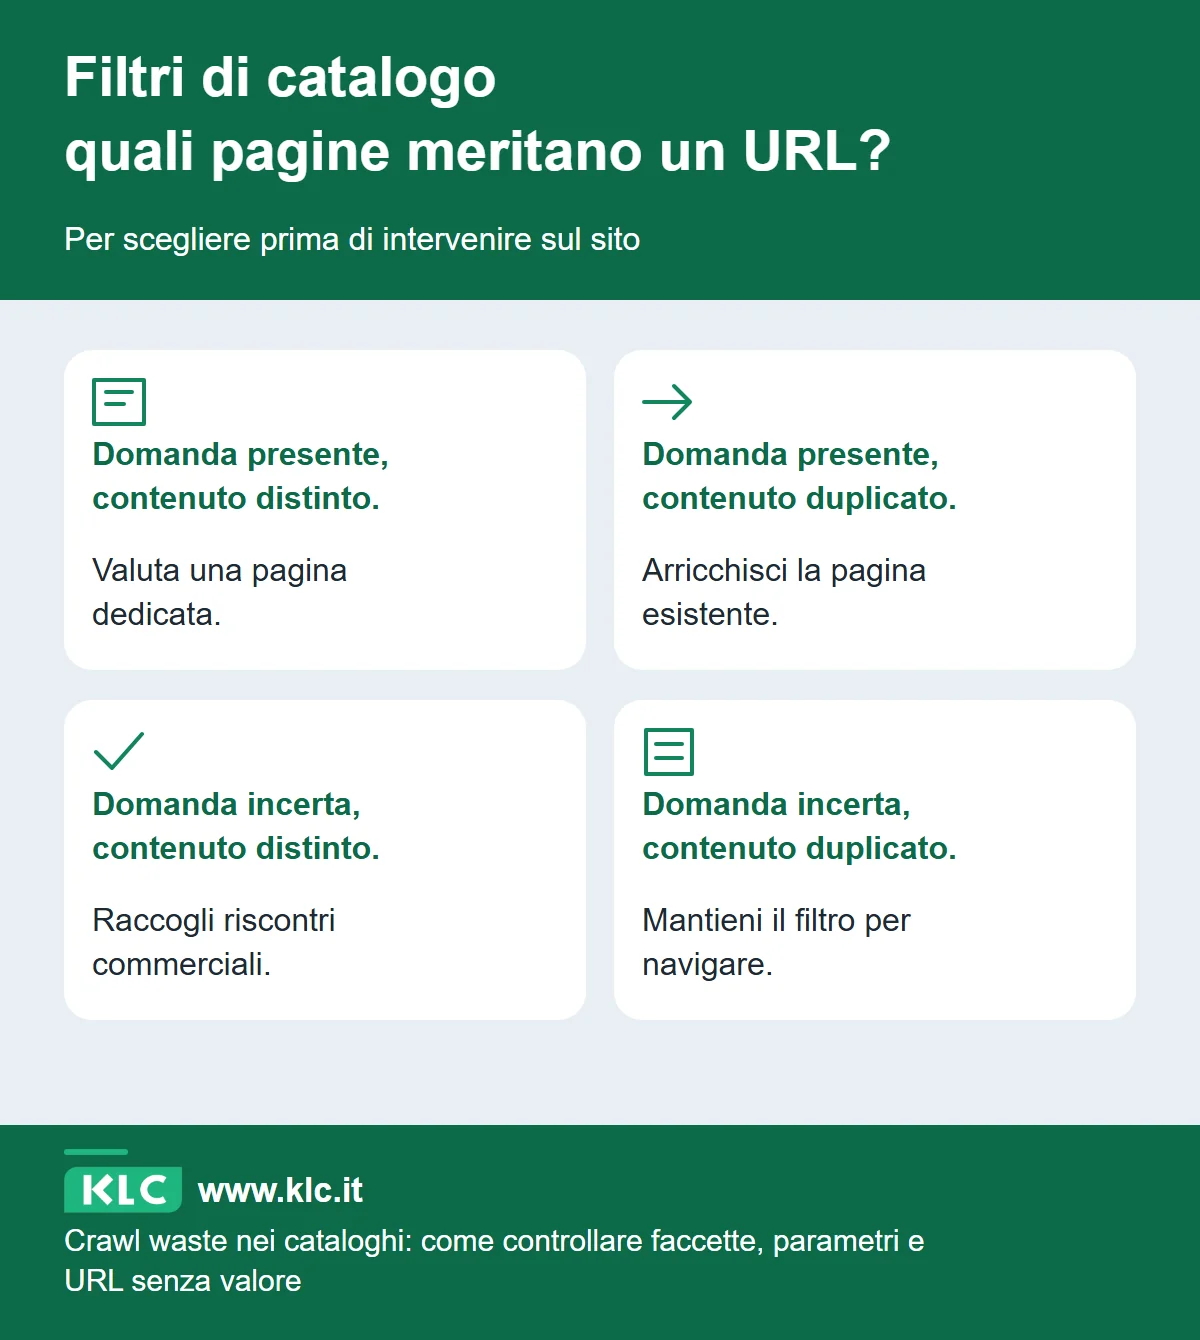
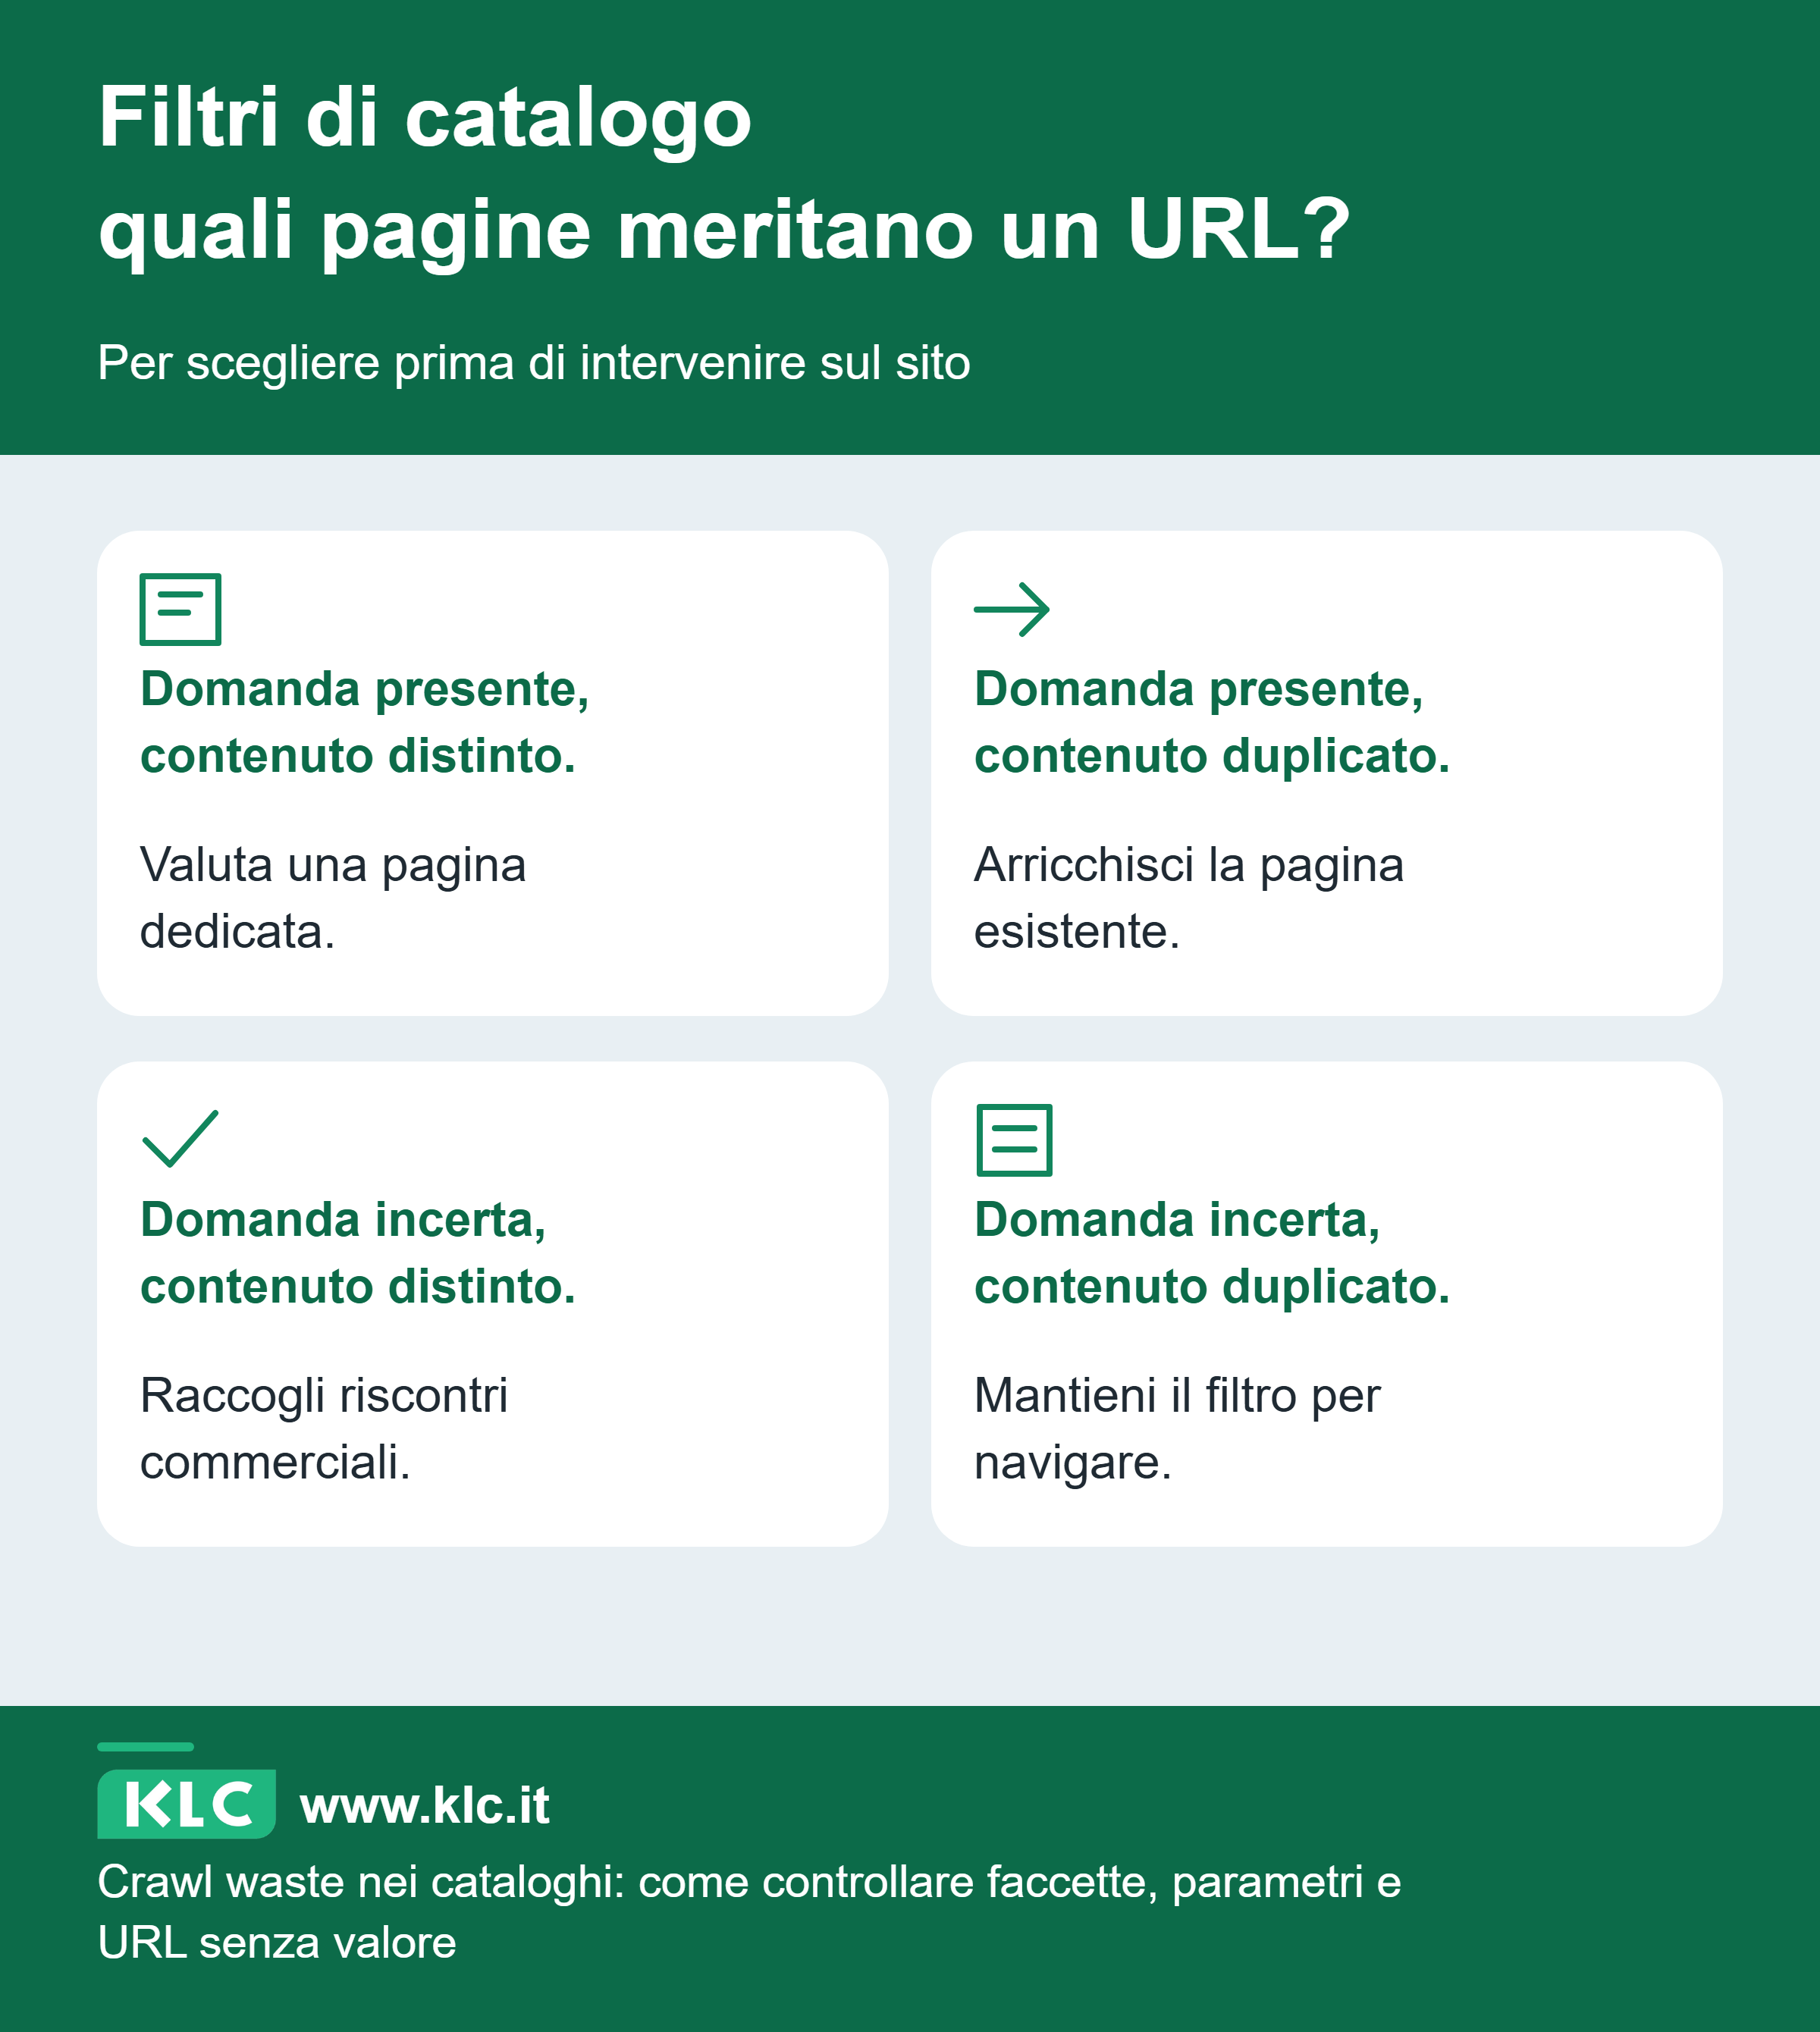
La matrice nell’infografica incrocia due domande, la presenza di una domanda riconoscibile e la disponibilità di contenuti diversi. Serve a discutere le faccette con chi conosce i prodotti prima di modificarne la gestione tecnica.
Scarica l’infografica (PNG ad alta risoluzione)
Incorpora l’infografica nel tuo sito
Puoi ripubblicare l’infografica usando questo codice, con il collegamento alla guida originale.
- Domanda presente, contenuto distinto. Valuta una pagina dedicata.
- Domanda presente, contenuto duplicato. Arricchisci la pagina esistente.
- Domanda incerta, contenuto distinto. Raccogli riscontri commerciali.
- Domanda incerta, contenuto duplicato. Mantieni il filtro per navigare.
Riconoscere lo stesso insieme di prodotti
Apri due combinazioni che sembrano diverse e confronta gli articoli mostrati. Un filtro selezionato in ordine diverso può generare un altro URL per la stessa selezione. Porta al fornitore entrambi gli indirizzi e il percorso seguito per ottenerli. Potrà correggere il modo in cui il sito costruisce i collegamenti, senza eliminare la possibilità di filtrare.
Se un filtro restituisce zero articoli, prova a raggiungerlo dalla categoria e da un indirizzo già salvato. I due percorsi possono comportarsi diversamente. Il controllo serve a evitare che il sito continui a proporre combinazioni vuote nei link, pur gestendo correttamente una visita diretta.
Il prodotto temporaneamente assente non è una faccetta inutile
La disponibilità del magazzino cambia più spesso delle applicazioni servite. Una categoria utile può restare senza articoli ordinabili per un periodo e tornare popolata in seguito. Prima di rimuoverla, chiarisci con il commerciale se il prodotto si può ordinare su richiesta e quale informazione dare al cliente. Un filtro «disponibile subito» e una categoria di prodotto hanno compiti diversi.
Per il collaudo scegli una famiglia che il responsabile di catalogo conosce bene. Prepara alcuni percorsi di acquisto reali, compreso il ritorno alla selezione precedente. Dopo la modifica controlla che il cliente possa ancora trovare gli articoli e inviare la richiesta corretta. Confronta poi i log su periodi di durata simile, annotando eventuali importazioni del catalogo o problemi del server che possono aver cambiato le richieste dei bot.
Domande frequenti
Googlebot ha un limite per singola pagina?
Google ha documentato nel 2026 un limite di fetch di 2 MB per molti URL non PDF; è distinto dal crawl budget del sito.
I parametri URL sono sempre negativi?
No. Sono un problema quando creano duplicati, spazi infiniti o segnali incoerenti.
Conviene disalloware i filtri?
Dipende da indicizzazione, linking e necessità di vedere canonical o noindex. Va progettato per pattern.
Che cosa fare
Scegli una famiglia del catalogo e raccogli i pattern generati dai filtri. Confrontali con le richieste di Googlebot nei log su un periodo definito, prima di proporre modifiche estese al sito.
Fonti e riferimenti
- Google Crawling Infrastructure — Crawl Budget Management — https://developers.google.com/crawling/docs/crawl-budget
- Google Crawling Infrastructure — Faceted navigation URLs — https://developers.google.com/crawling/docs/faceted-navigation
- Google Search Console — Crawl Stats report — https://support.google.com/webmasters/answer/9679690?hl=en
Come trasformare la guida in un’attività concreta
Classificare tutti i pattern di URL, incrociare crawl e log, scegliere quali faccette meritano landing e rimuovere alla fonte le combinazioni prive di valore.
Approfondisci il servizio: SEO tecnica.